Un plan du site web ne se limite pas à un fichier XML soumis à Google Search Console. C’est un document d’architecture qui détermine la profondeur de crawl, la répartition du PageRank interne et la capacité des utilisateurs à atteindre n’importe quelle page en trois clics maximum. Nous observons régulièrement des sites dont le sitemap HTML et le sitemap XML divergent, ce qui crée des incohérences d’indexation et dégrade la navigation réelle.
Critères WCAG 2.2 qui changent la conception d’un plan du site
La version WCAG 2.2, publiée le 5 octobre 2023, introduit des exigences directement liées à la structure de navigation. Les articles grand public traitent rarement ces critères, alors qu’ils conditionnent la conformité légale de nombreux sites en Europe.
Le critère 2.4.11 (Focus Not Obscured, niveau AA) impose que l’élément ciblé au clavier ne soit jamais entièrement masqué par un header sticky, une bannière cookies ou un widget de chat. En pratique, cela oblige à repenser la hauteur des menus fixes et l’empilement des overlays dans le plan de page.
Le critère 3.2.6 (Consistent Help, niveau A) exige que tout mécanisme d’aide (lien contact, FAQ, chat) apparaisse dans la même position relative sur chaque page du site. Un plan du site qui ne prévoit pas cet emplacement dès la phase d’arborescence génère des corrections coûteuses en production.
Le critère 2.5.8 (Target Size Minimum, niveau AA) fixe une zone de cible minimale de 24 x 24 pixels pour les éléments interactifs. Les menus de navigation denses, avec des liens serrés sur mobile, échouent souvent à ce test. Nous recommandons de valider la taille des cibles dès le wireframe du sitemap visuel.
Sitemap XML et sitemap HTML : deux fonctions distinctes dans l’architecture web
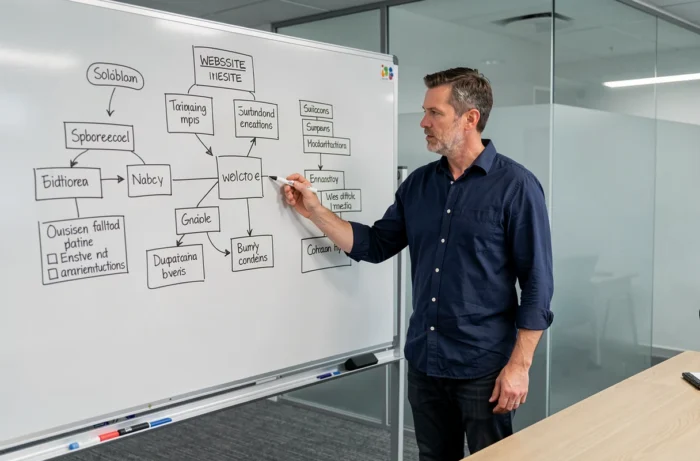
Confondre sitemap XML et sitemap HTML reste l’erreur la plus fréquente. Le fichier XML s’adresse aux robots d’indexation de Google et des autres moteurs de recherche. Le sitemap HTML est une page accessible aux visiteurs, qui liste les catégories et les pages du site dans une arborescence lisible.
Pour illustrer cette complémentarité, le plan du site www Site de Bankai fonctionne comme une table des matières destinée aux utilisateurs, là où le fichier XML correspondant cible uniquement les crawlers.
Un sitemap HTML bien conçu réduit la profondeur de navigation. Chaque page importante devient accessible en deux clics depuis la racine, ce qui améliore le budget de crawl et l’expérience utilisateur simultanément. Le sitemap XML, lui, doit refléter exactement les URLs canoniques, sans inclure les pages en noindex ou les redirections 301.
Signaux de divergence à surveiller
- Des URLs présentes dans le sitemap XML mais absentes du sitemap HTML indiquent des pages orphelines que Google indexe sans que les visiteurs puissent les atteindre par la navigation.
- Des URLs listées dans le sitemap HTML mais exclues du XML créent une incohérence : le site affiche des liens vers des pages qu’il demande implicitement à Google de ne pas crawler.
- Un sitemap XML contenant des URLs en erreur 404 ou en redirection dégrade la confiance du robot d’indexation et ralentit le crawl des pages réellement actives.
Maillage interne piloté par le plan du site
Le plan du site détermine la distribution du PageRank interne. Sans cartographie préalable, les liens internes s’accumulent de manière aléatoire, concentrant l’autorité sur la page d’accueil et les pages de catégories principales au détriment du contenu profond.
Nous structurons le maillage en partant de l’arborescence du sitemap HTML. Chaque niveau hiérarchique (accueil, catégories, sous-catégories, pages finales) reçoit un nombre de liens entrants proportionnel à sa priorité SEO. Ce principe évite la dilution du jus de lien vers des pages à faible valeur.
Profondeur de clics et impact sur l’indexation
Une page située à plus de trois clics de la racine a statistiquement moins de chances d’être crawlée régulièrement. Le plan du site sert de filet de sécurité : même si la navigation principale ne mène pas directement à une page profonde, le sitemap HTML garantit un chemin d’accès en deux clics maximum.
Les liens contextuels dans le contenu renforcent ce maillage. Un lien placé dans un paragraphe pertinent transmet plus de valeur sémantique qu’un lien générique en pied de page. Le plan du site identifie les connexions thématiques entre pages pour guider cette stratégie de liens internes.
Erreurs d’arborescence qui sabotent la navigation et le SEO
Un menu de navigation surchargé ne compense pas une arborescence mal pensée. Au-delà de sept items dans le menu principal, le taux de clic par item chute fortement. Nous préconisons de limiter le premier niveau à cinq ou six entrées, puis d’utiliser des sous-menus ciblés.
Les structures trop plates posent un problème symétrique. Un site qui place toutes ses pages au même niveau hiérarchique empêche Google de comprendre les relations sémantiques entre contenus. Le moteur de recherche peine à identifier les pages piliers et les pages satellites.
Cannibalisation et URLs dupliquées
Une arborescence floue favorise la cannibalisation SEO : deux pages ciblent le même mot-clé sans que le plan du site ne définisse laquelle est prioritaire. La solution passe par un audit de l’arborescence, page par page, en croisant chaque URL avec son mot-clé cible et sa position dans la hiérarchie.
Les URLs dupliquées (avec et sans slash final, versions www et non-www) doivent être traitées dans le sitemap XML par des balises canoniques cohérentes. Un plan du site propre élimine ces doublons avant qu’ils ne fragmentent l’autorité de domaine.
La navigation efficace sur un site web repose sur une décision d’architecture prise en amont, pas sur des correctifs appliqués après la mise en ligne. Le plan du site, qu’il soit HTML ou XML, reste le seul document qui force à penser la totalité des chemins de navigation avant d’écrire la première ligne de code.